AI大收割03-数字劳动理论与AI剥削边界
一、一个理论空白
上一篇文章揭示了AI背后被遮蔽的五层劳动结构。我们看到了数据标注工人的血汗劳动、互联网创作者的无偿贡献、AI用户的"消费即劳动"、被替代者的双重剥夺,以及人类文明遗产被一次性"吞噬"。
这幅图景是触目惊心的。但当我们试图用理论来解释这些现象时,我们遇到了一个困难。
经典马克思主义的剥削理论建立在一个明确的前提之上:剥削发生在雇佣劳动关系中。 资本家雇佣工人,支付工资,工人的劳动创造的价值超过工资——超出的部分就是剩余价值。这个分析框架简洁有力,但它有一个前提:你得是一个被雇佣的工人。
问题是:在AI的五层价值攫取体系中,只有第一层(数据标注工人)完全符合这个前提。
第二层的知乎作者不是OpenAI的员工。第三层的ChatGPT用户没有和微软签劳动合同。第四层被替代的翻译的过去作品被用于训练,但她从未被这些AI公司雇佣过。第五层——人类文明本身——更不可能和任何公司建立雇佣关系。
那么,这些层次中发生的事情算不算"剥削"?如果不是经典意义上的剥削,那它是什么?
我们需要引入新的理论工具。
二、数字劳动理论的基本主张
Christian Fuchs的核心论点
在信息社会研究领域,奥地利学者Christian Fuchs(克里斯蒂安·福克斯)提出了一套系统的"数字劳动"(digital labor)理论。他的核心主张可以概括为:
互联网用户在使用社交媒体和数字平台时所进行的活动,构成了一种无偿劳动。平台公司将这种劳动的产物(用户数据、用户生成内容)转化为利润,而用户没有获得相应的报酬。这构成了一种新型的剥削关系。
Fuchs的论证链条如下:
- 用户在Facebook/Twitter/Instagram等平台上发帖、点赞、评论、浏览
- 这些活动产生了数据
- 平台利用这些数据向广告商出售精准广告
- 广告收入构成了平台公司的核心利润
- 用户没有因为自己的数据被商业化而获得报酬
- 因此,用户被剥削了
Tiziana Terranova的"免费劳动"
意大利学者Tiziana Terranova(蒂齐亚纳·特拉诺瓦)在更早的时候(2000年)就提出了"免费劳动"(free labor)的概念。她指出,互联网经济从一开始就建立在用户的无偿贡献之上——聊天室的版主、论坛的内容贡献者、早期博客作者——这些人为互联网创造了吸引力和价值,但几乎没有获得经济回报。
Terranova的洞察在于:数字经济中的"免费"有两层含义——free as in freedom(自由的)和free as in free beer(免费的)。 用户看似自由地在互联网上活动,但他们的活动同时也是免费的——为平台公司免费工作。
基本逻辑链条
将Fuchs和Terranova的理论综合起来,数字劳动理论的基本逻辑可以概括为:
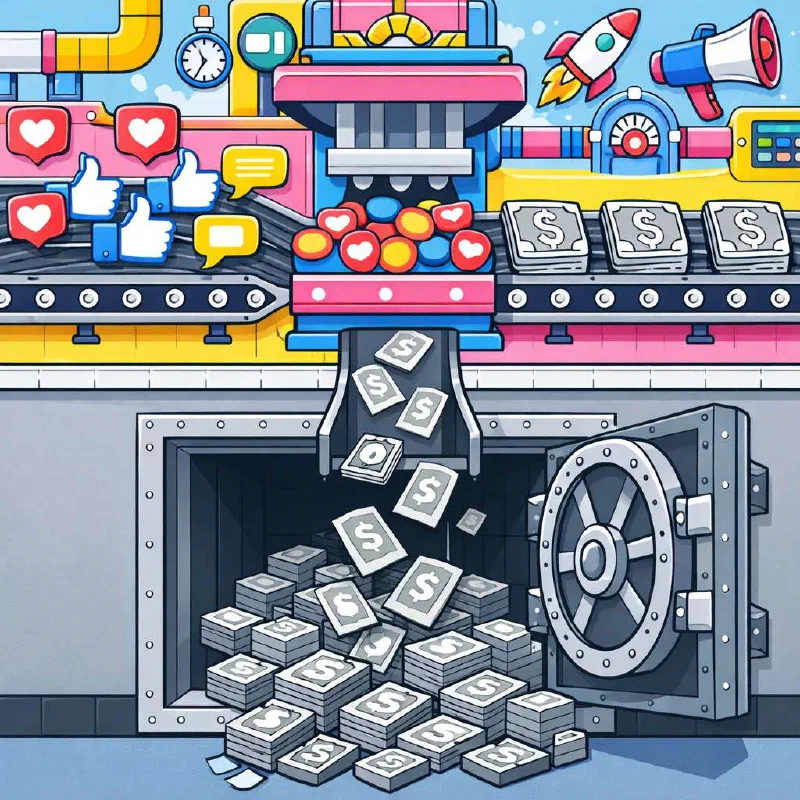
用户活动 → 产生数据 → 平台将数据转化为利润 → 用户未获得相应补偿 → 这构成了剥削
这个逻辑为什么引起了广泛关注?因为它让一个被长期忽视的事实变得可见:互联网经济的利润并非凭空产生,它来源于亿万用户的日常活动。 Facebook的市值不是马克·扎克伯格一个人创造的——是30亿用户的每日互动创造了它的核心资产。
三、数字劳动概念应用于AI的强大解释力
当我们把数字劳动理论从社交媒体领域延伸到AI领域,它展现出了更加强大的解释力。
完美解释了训练数据的来源
大语言模型的训练数据——数以万亿词元的文本——绝大部分来自互联网用户的免费贡献。数字劳动理论精准地描述了这个过程:用户的创作活动(写文章、答问题、编写代码)产生了内容,这些内容被AI公司用来训练模型,模型被商业化,利润归公司——用户什么也没得到。
与社交媒体时代相比,AI时代的"数字劳动"攫取更加直接、更加彻底。在社交媒体时代,用户数据被用来投放广告——这至少还是一个间接的价值转化过程。但在AI时代,用户创作的内容直接成为了产品的原材料——AI模型就是从这些内容中"学到"能力的。
让被遮蔽的劳动变得可见
数字劳动理论的最大贡献之一,就是让那些被日常生活的表象所遮蔽的劳动关系变得可见。当我们说"你在知乎上写文章就是在为AI公司做无偿劳动"时,虽然这个说法可能需要修正(我们稍后会讨论),但它至少迫使人们正视一个事实:AI的价值不是从真空中产生的,它来源于无数人的无偿贡献。
将剥削概念从工厂扩展到整个互联网
传统的剥削发生在工厂里,在特定的时间和空间内。数字劳动理论把剥削的概念扩展到了整个互联网空间——任何人在任何时间、任何地点的在线活动,都可能在为平台和AI公司创造价值。
这意味着"工作日"的概念被彻底消解了。在马克思的时代,资本家延长工作时间来增加剩余劳动。在数字时代,“工作"变成了24小时不间断的——因为你上网的每一分钟都在"劳动”。
与经典马克思框架的对接
数字劳动理论试图与马克思的框架对接:如果用户的在线活动是一种劳动,那么它产生的价值就是剩余价值;平台对这种剩余价值的占有就是剥削;平台的利润率可以被分析为剥削率的函数……
这套论述在逻辑上是融贯的,也在政治上具有强大的动员力。但正因如此,我们更需要严格地审视它的局限性。
四、但不能回避的困难
数字劳动理论的解释力是强大的,但它也面临着一系列严肃的理论挑战。回避这些挑战只会削弱理论的可信度。
边界问题:什么算"数字劳动"?
如果在知乎上写一篇三千字的分析文章算数字劳动,那么:
- 发一条朋友圈呢?
- 给朋友的照片点一个赞呢?
- 在淘宝上浏览商品但什么也没买呢?
- 走在街上被监控摄像头拍到,面部数据被采集呢?
- 你的手机在口袋里被动地传输位置数据呢?
如果所有这些都算"劳动",那"劳动"这个概念就被稀释到了无意义的程度。在马克思那里,劳动是有意识的、有目的的人类活动——它不是一个可以无限扩展的范畴。
如果我们说"你活着就是在劳动",这个命题虽然听起来很激进,但它实际上失去了所有的分析力。如果一切都是劳动,那我们就无法区分不同活动的性质和被剥削的程度。
自愿性问题:你是被迫的吗?
马克思分析的经典剥削有一个关键的结构性前提:工人不得不出卖劳动力,因为他们没有其他的生存手段。 工人在形式上是"自愿"签订劳动合同的,但这种"自愿"是虚假的——不工作就会饿死。
互联网用户的情况有所不同。没有人拿枪逼你上知乎,没有人强迫你写博客。你可以选择完全不使用社交媒体——虽然这会让你失去很多社交联系和信息来源,但你不会因此饿死。
Fuchs对此有一个回应:在当代社会,不使用互联网等同于"社会性死亡"——你无法获取信息、无法社交、无法参与公共生活。因此,使用互联网和工人出卖劳动力一样,本质上是被迫的。
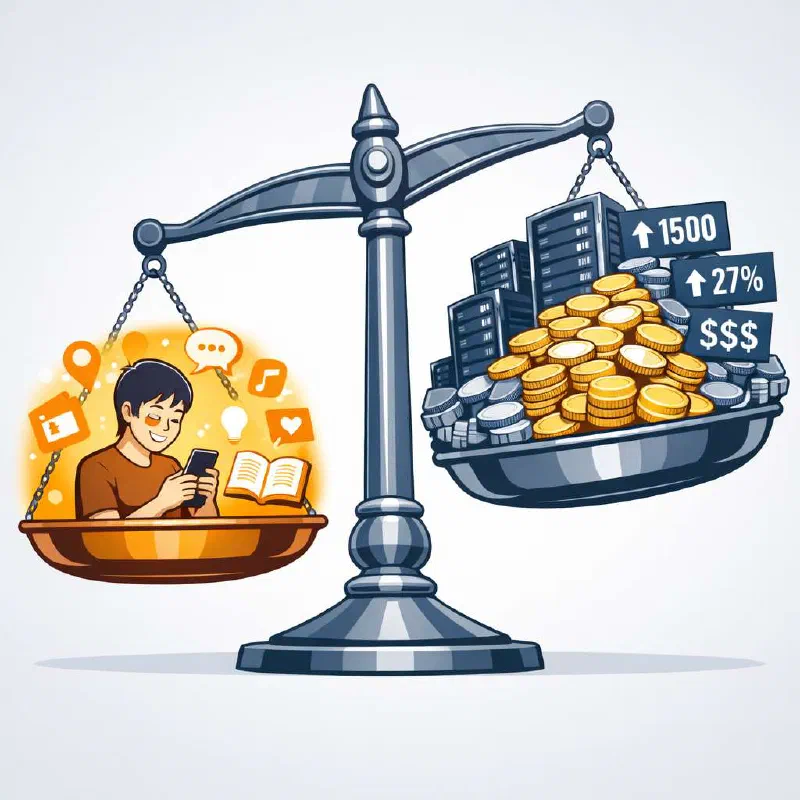
这个回应有一定的道理,但也有明显的局限。在知乎上写一篇三千字的文章和在工厂里上十二小时的班,两者的"强制性"确实不在一个量级。 前者至少在很大程度上是自我表达的需求驱动的,后者则几乎完全是生存压力驱动的。把两者等同起来,会模糊真正严酷的剥削与相对温和的价值占用之间的区别。
量化问题:一条微博值多少钱?
马克思的剩余价值理论之所以有力,部分原因在于它是可量化的(至少在原则上):工人一天创造了100元的价值,得到了50元的工资,被剥削了50元的剩余价值。
但数字劳动该怎么量化?一条知乎回答对GPT-4模型的贡献值多少钱?一次"点赞"操作的价值是多少?一个小时的浏览行为产生了多少"剩余价值"?
这些问题在目前的技术和理论条件下几乎无法回答。而如果无法量化,“剥削率"就无法计算,“剩余价值"就成了一个比喻性的概念而非分析性的工具。
使用价值问题:用户确实获得了服务
还有一个不能忽视的事实:互联网用户从平台上获得了真实的服务。
你在知乎上写文章,但你也在知乎上读到了其他人的精彩文章。你在使用ChatGPT时提供了反馈数据,但你也得到了一个强大的AI助手。你在微信上的社交活动产生了数据,但你也通过微信维系了重要的人际关系。
如果我们说用户被"剥削"了,我们需要把用户获得的使用价值也考虑进去。简单地忽视这一面,会让理论显得片面。
这不意味着一切都是公平的——平台获得的价值可能远远大于它提供给用户的服务价值。但如果不去认真分析这种交换关系,我们的批判就缺乏说服力。
五、解决方案:不要一刀切,分层使用
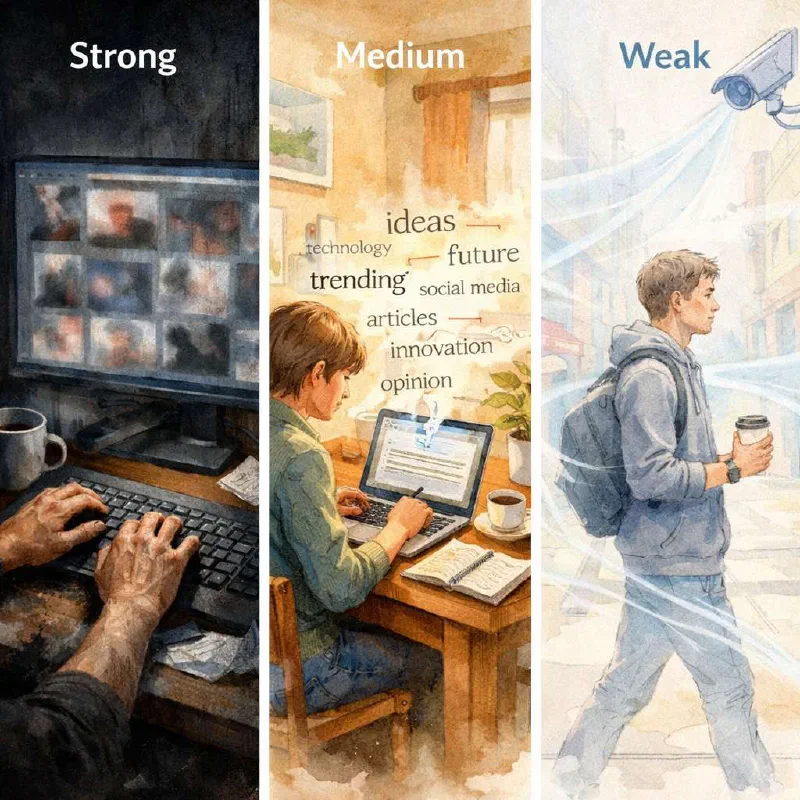
面对上述困难,我认为最有成效的方式不是全面拥抱或全面否定数字劳动理论,而是分层使用——针对不同类型的数字活动,使用不同强度的"劳动"概念。
强意义数字劳动
适用对象: 数据标注工人、RLHF训练师、内容审核员
特征:
- 存在明确的雇佣关系(尽管可能通过层层外包来模糊)
- 劳动具有明确的目的性和指令性
- 劳动时间可以被精确计量
- 报酬远低于劳动创造的价值
理论工具: 完全适用经典马克思剩余价值理论。这就是标准的资本主义剥削,只不过披上了"灵活用工"“众包"“数字经济"的外衣。
中等意义数字劳动
适用对象: 知乎/Reddit长文作者、Stack Overflow技术问答贡献者、开源代码贡献者、Wikipedia编辑者、专业博主
特征:
- 不存在雇佣关系
- 但劳动具有明确的意识性和目的性——创作者知道自己在生产知识内容
- 劳动成果具有独立的、可辨识的形态(一篇文章、一段代码)
- 这些劳动成果被明确地用于AI训练,贡献可以被追溯
理论工具: 不适合直接套用剩余价值理论(因为没有雇佣关系),但可以使用"无偿占用"的概念。这些创作者的知识劳动创造了有价值的内容,这些内容被AI公司无偿使用。尽管创作者获得了平台的服务作为某种"补偿”,但这种补偿与其劳动成果被商业化后产生的价值之间存在巨大的不对称。
可以借用David Harvey的"剥夺性积累"概念:价值被从创作者那里转移到了AI公司,尽管创作者名义上没有"失去"什么(文章还在那里)。
弱意义数字劳动
适用对象: 被动行为数据的生产者——浏览记录、点击行为、位置数据、被动搜集的面部数据等
特征:
- 不存在雇佣关系
- 活动缺乏劳动的意识性和目的性——人们并非有意识地在"生产"数据
- 数据是日常生活的副产品,而非主动的创造活动
- 很难辨识个体的"贡献”
理论工具: 用"劳动"来描述这种情况是勉强的。更适合使用"数字租金攫取”(digital rent extraction)的概念——平台和AI公司不是在"剥削劳动”,而是在提取租金。它们控制了一种特殊的"资源"——用户的行为数据和注意力——并从中攫取经济价值,类似于地主控制土地并向农民收取地租。
为什么分层很重要
如果不加区分地把所有互联网活动都称为"劳动"、把所有价值获取都称为"剥削",我们不仅在理论上失去了精确性,在政治上也会失去可信度。
一个肯尼亚的数据标注工人挣着不到2美元的时薪、忍受着令人创伤的审核内容——她的处境和一个在地铁上刷抖音的白领的处境,显然不可同日而语。把两者都叫做"被剥削的数字劳工",不仅在理论上是不严谨的,在道德上也是对前者苦难的轻视。
分层使用理论工具,才能让分析既有深度又有精确性。
六、数字劳动理论的最大价值
不在于解释一切,而在于提出正确的问题
经过上面的讨论,我们可以看到,数字劳动理论并不是一个完美的分析工具。它有强大的解释力,但也有明显的边界。
然而,它的最大价值可能不在于提供一个完美的解释,而在于提出了正确的问题——
如果AI的价值来源于全人类的贡献——从数据标注工人的血汗劳动到全人类的知识遗产——那么,全人类是否应该分享AI创造的收益?
这个问题一旦被提出,就很难被忽视。
政策含义
这个问题并非只有理论意义。它直接指向了一系列正在全球范围内被讨论的政策方案:
AI税(AI Tax): 对AI公司征收特别税,理由是它们使用了全社会的数据和知识来获利。这类似于资源税的逻辑——如果你开采了公共矿产,你应该向公共支付费用。
数据分红(Data Dividend): 既然用户的数据被用来创造利润,那么用户就应该从中获得分红。加州州长加文·纽森在2019年就提出过"数据分红"的概念。
全民基本收入(UBI): 如果AI大规模替代劳动导致大量失业,全民基本收入可能成为必要的社会保障手段。其资金来源之一就可以是AI产生的利润。
数据主权和数据公地: 从根本上重新定义数据的所有权——数据不是企业的私有资产,而是一种公共资源,应该由社会集体管理和分配。
为第四篇奠定基础
但这里有一个更深层的问题:即使我们实施了上述所有政策,即使AI的利润被合理地再分配——人类集体知识被私有化的结构性问题解决了吗?
知识还属于全人类吗?当AI成为你获取知识的主要中介,而这个中介是一家私人公司的收费产品——知识的公共属性还在吗?
这正是下一篇要深入讨论的问题。
上一篇:谁的劳动喂养了AI?——五层价值攫取体系 下一篇:人类的知识还属于人类吗?——集体知识的价值私有化
本文写作中使用了 AI 辅助。文字采用 CC BY-NC-SA 4.0 许可。